Lien source de cet article.
Auteur :
Fin juillet 2026, deux informations sont tombées à dix jours d’intervalle, et elles
parlent en réalité du même sujet. D’un côté, France Travail détaille son arsenal
d’intelligence artificielle : cinq outils déjà en service auprès de
30 000 conseillers, pour 15 millions d’euros investis.
De l’autre, l’association La Quadrature du Net révèle, le 20 juillet, l’existence d’un
algorithme qui sélectionne les demandeurs d’emploi à contrôler en priorité — et un
sénateur demande désormais des comptes au gouvernement.
Les deux faces d’une même pièce : le premier opérateur de l’emploi en France, qui est
aussi l’un des premiers prescripteurs de formation du pays, industrialise l’IA. Pour un
organisme de formation, un CFA ou un formateur, ce n’est pas un débat abstrait : c’est le
robinet de vos entrées en formation qui change de mécanisme.
Côté conseillers : cinq outils déjà en production
Commençons par ce qui fonctionne. France Travail a déployé une gamme d’outils qui ne
relèvent plus du pilote de laboratoire — le taux d’utilisation quotidienne par les
conseillers atteint 70 %.
| Outil | À quoi ça sert | Résultat annoncé |
|---|---|---|
| Chat FT | Assistant conversationnel interne, entraîné sur les données de l’établissement : il résume les entretiens et retrouve l’information réglementaire | ≈ 3 heures gagnées par semaine et par conseiller |
| Neo | Interroger les bases de données en langage courant (« montre-moi les offres de soudeur à moins de 30 km ») au lieu de naviguer dans les écrans | Accès direct sans passer par un expert |
| Chat FT Écoute | Transcription automatique des entretiens en présentiel | 91 % de fiabilité, en test dans six régions dont La Réunion et la Nouvelle-Aquitaine |
| Match FT | Rapprochement entre les offres et les profils, volet « Offre » et volet « Formation » | Qualification d’un profil par SMS en 1 h 30 au lieu de 3 jours |
| Coach FT | Service vocal d’aide aux usagers et aux recruteurs, notamment pour rédiger les annonces | Une annonce optimisée aurait 5 fois plus de chances d’être pourvue |
Sur le plan technique, France Travail a fait un choix qui mérite d’être noté :
les modèles de langage viennent de Mistral AI, l’entreprise française, et
tournent sur ses propres serveurs, à Montpellier et Orléans. Traduction : les données des
demandeurs d’emploi ne partent pas chez un géant américain du cloud. Pour un établissement
qui gère les dossiers de 15 millions de personnes, ce n’est pas un détail de communication.
Le volet qui concerne directement les organismes de formation
Un chiffre doit retenir l’attention de tout organisme de formation : le volet
« Formation » de Match FT génère + 17 % d’inscriptions, avec une
satisfaction déclarée de 4,75 sur 5. Concrètement, quand un conseiller
reçoit une personne, l’outil lui propose automatiquement les formations pertinentes au vu
du profil, du bassin d’emploi et des offres non pourvues alentour — au lieu de compter sur
la connaissance personnelle du catalogue par le conseiller.
Prenons un cas simple. Un organisme forme des conducteurs d’engins en Nouvelle-Aquitaine
et remplit habituellement 60 places par an via les prescriptions de France Travail. Si le
moteur de recommandation identifie bien sa session, le mécanisme joue en sa faveur :
+ 17 %, cela ferait une dizaine d’entrées supplémentaires, sans un euro de prospection.
Si en revanche sa formation est mal décrite, mal rattachée à un code métier ou absente du
catalogue régional référencé, elle devient tout bonnement invisible pour l’algorithme — et
la connaissance qu’en avait le conseiller du coin ne suffira plus à compenser. Il n’y a pas
de recours à un moteur qui ne vous voit pas.
C’est un changement de nature du travail commercial d’un organisme : hier, on entretenait
une relation avec des conseillers ; demain, il faut aussi être correctement « lisible » par
une machine. Les deux, en réalité — mais le second devient déterminant.
L’autre nouvelle : un algorithme qui trie les chômeurs à contrôler
Le 20 juillet 2026, La Quadrature du Net, en partenariat avec la cellule investigation de
Radio France, a publié un document interne : la présentation faite le 10 décembre 2025 au
comité d’éthique IA de France Travail. On y découvre un outil au nom sans ambiguïté,
« Ciblage du Contrôle de la Recherche d’Emploi ».
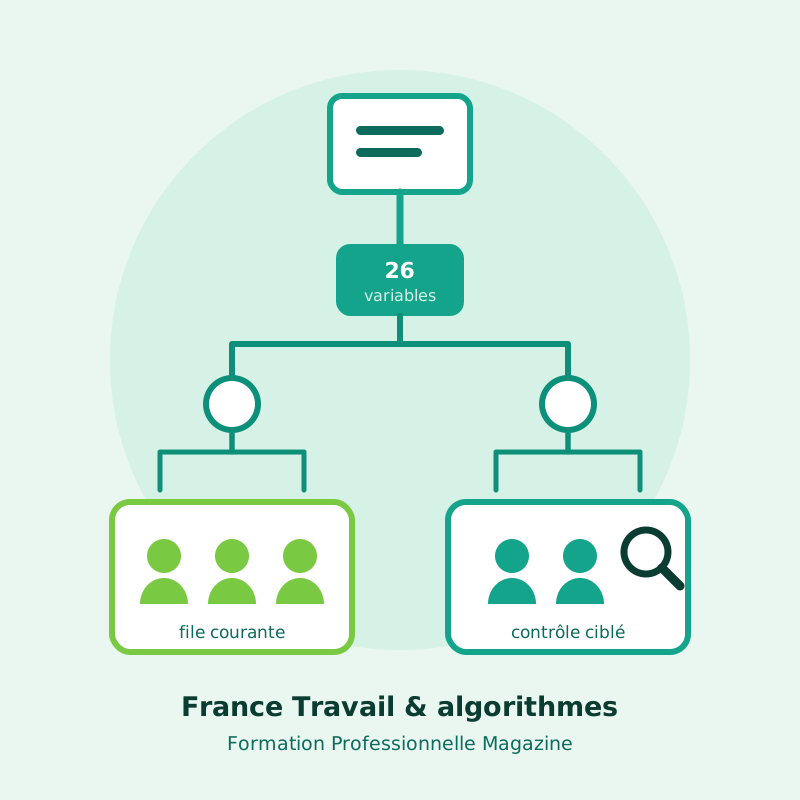
Le principe, expliqué simplement : l’algorithme a appris sur
60 000 contrôles passés, par une technique d’arbre de décision — imaginez
une longue suite de questions oui/non (« la personne s’est-elle connectée à son espace
ce mois-ci ? », « son CV est-il visible ? », « ses candidatures correspondent-elles à son
parcours ? ») qui, en s’enchaînant, débouchent sur un score. Au total,
26 variables nourrissent ce score, dont l’historique d’inscription, le
niveau de formation et les manquements passés. La liste complète des règles n’est, elle,
pas publique.
Les ordres de grandeur donnent la mesure de l’enjeu. En 2025, France Travail a réalisé
1,25 million de contrôles, dont 500 000 ciblés — soit
40 % du total. Et depuis le 1er janvier 2026, l’inscription à France Travail
étant devenue obligatoire pour les bénéficiaires du RSA, ce sont potentiellement
plus de 6 millions de personnes qui entrent dans le périmètre. Les phases
de test ont porté sur deux campagnes d’environ 7 000 dossiers chacune, ciblées sur des
personnes en rupture conventionnelle.
La question remonte au Sénat
Dix jours plus tard, le 30 juillet 2026, le sénateur Éric Kerrouche
(Landes, groupe socialiste) publie au Journal officiel une question écrite adressée à la
ministre du Travail et des Solidarités. Son argument est précis : on connaît les
26 variables, mais pas les règles qui les combinent — donc il est
impossible de vérifier si le tri produit une discrimination. Il s’appuie
sur deux textes : la convention du Conseil de l’Europe sur l’IA et les droits humains du
17 mai 2024, et le règlement européen 2024/1689 du 13 juin 2024 (l’« AI Act »). Sa
question tient en une ligne : quand le code source sera-t-il rendu public, ou à défaut,
sur quel motif le gouvernement justifie-t-il de ne pas le publier ? À ce jour, la réponse
ministérielle n’est pas parue.
Les deux points de vue, honnêtement
Il serait facile de trancher d’un côté ou de l’autre. Regardons les deux.
Du côté de France Travail, la logique se défend. L’établissement doit
accompagner 15 millions d’usagers avec des moyens qui se resserrent : la loi de finances
2026 prévoit 515 suppressions de postes, et l’IA est justement présentée
comme le moyen de redéployer 800 équivalents temps plein vers
l’accompagnement direct à l’horizon 2027. Autrement dit : automatiser la paperasse pour
remettre des humains en face des gens. Quant au contrôle ciblé, il existait déjà avant
l’algorithme — un conseiller décidait, avec ses propres biais, qui contrôler. Un modèle
entraîné sur 60 000 dossiers n’est pas forcément plus injuste qu’une intuition
individuelle non tracée.
Du côté des demandeurs d’emploi, l’objection est tout aussi solide.
Quand une décision qui peut aboutir à une radiation repose sur un score dont personne ne
peut examiner la mécanique, la personne visée n’a aucun moyen de se défendre : on ne
conteste pas ce qu’on ne voit pas. S’ajoute un risque plus insidieux, souligné dans le
document : la déresponsabilisation. Un agent à qui la machine désigne un
dossier « à risque » aura naturellement tendance à ne pas remettre en cause ce que
l’outil présente comme une objectivité technique. Enfin, la crédibilité de l’établissement
sur la donnée reste fragile : le 22 janvier 2026, la CNIL lui a infligé une amende de
5 millions d’euros pour défaut de sécurité, après la fuite massive de
données de 2024.
Ces deux lectures ne s’annulent pas. On peut parfaitement penser que l’outillage IA des
conseillers est une bonne nouvelle et que l’opacité du ciblage est un vrai problème — c’est
même, sans doute, la position la plus raisonnable.
Ce que les OF, CFA et formateurs peuvent en retenir
Un : soignez la lisibilité machine de votre offre. Intitulés,
codes métiers (ROME), certifications rattachées, lieux, dates, prérequis : ce qui est flou
ou manquant dans les catalogues référencés vous rend invisible pour un moteur de
recommandation. Ce travail ingrat de qualité des données est devenu un travail commercial.
Deux : ne misez pas tout sur la prescription. Si un algorithme peut
faire + 17 % d’entrées, il peut aussi en faire – 17 % le jour où le paramétrage change.
Un organisme dont 80 % des entrées dépendent d’un unique prescripteur est exposé à une
décision technique sur laquelle il n’a aucune prise.
Trois : préparez vos apprenants à la question. Les personnes que vous
formez sont, pour beaucoup, inscrites à France Travail. Savoir que la régularité des
connexions, la visibilité du CV et la cohérence des candidatures pèsent dans un score fait
partie, aujourd’hui, de l’accompagnement élémentaire — sans dramatiser, mais sans le taire.
Quatre : suivez la réponse ministérielle. Si le code source ou les
règles de scoring sont publiés, ce sera une première utile pour tout le secteur : cela
créera un précédent sur ce qu’un opérateur public doit rendre lisible quand il automatise
une décision qui touche des droits.
Le vrai sujet n’est pas l’IA, c’est ce qu’on en montre
Il n’y a rien de choquant à ce que le service public de l’emploi utilise de l’IA — 15
millions de dossiers ne se traitent pas à la main, et faire gagner trois heures par semaine
à 30 000 conseillers est une bonne chose pour tout le monde, y compris pour les organismes
de formation qui verront des conseillers plus disponibles. La ligne de partage ne passe pas
entre l’IA et le reste. Elle passe entre les usages qu’on assume et qu’on documente, et
ceux qu’on garde sous le coude. Un outil qui recommande une formation peut se tromper sans
grande conséquence : on en propose une autre. Un outil qui désigne une personne à contrôler
engage, lui, une décision qui peut coûter un revenu. Il est logique qu’on n’exige pas le
même niveau de transparence des deux — et c’est précisément ce que le Sénat vient de
demander.